OpenAI с първи собствен AI чип: Jalapeño изпъква с обещаващи резултати
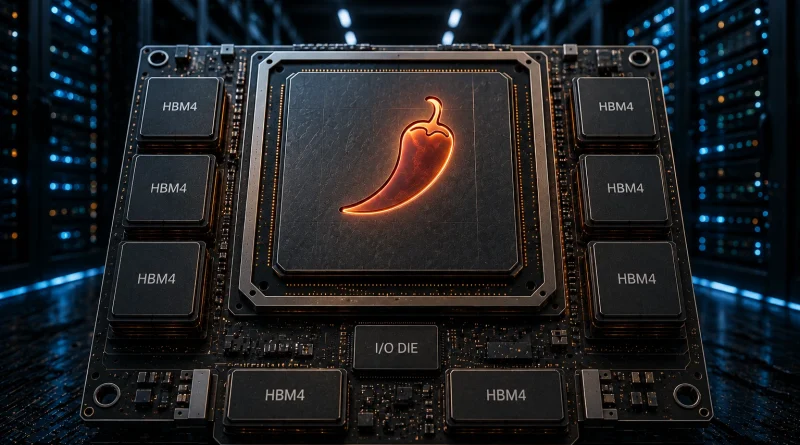
През юни OpenAI показа Jalapeño („халапеньо“ – люта чушка), първия си специално разработен AI чип, създаден съвместно с Broadcom. Името звучи почти шеговито за нещо, което ще работи в центрове за данни и ще обработва огромни количества промптове. Зад него обаче стои съвсем сериозен план: OpenAI иска постепенно да изгради собствена хардуерна платформа за своите модели.
Днес този план демонстрира първите си измерими резултати. OpenAI е подложила Jalapeño на тестове чрез InferenceX на SemiAnalysis, използвайки GPT-OSS 120B, DeepSeek R1 и Kimi K2.5. При сравнените натоварвания компанията отчита между 1.5 и 1.9 пъти по-висока производителност на ват и между 1.7 и 3.6 пъти по-ниска крайна латентност – времето, необходимо за получаването на резултат. При силно интерактивни натоварвания предимството в производителността достига до 4.1 пъти. SemiAnalysis е участвала в измерванията, но публикуваните числа и методологията са представени от OpenAI, затова резултатите трябва да се разглеждат в рамките на конкретните тестове, а не като универсално сравнение с всички продукти на Nvidia.
Числата са впечатляващи. По-интересно е какво стои зад тях.
Какви разходи поема OpenAI, докато AI ни говори
За човек от другата страна на екрана един AI отговор е почти езотерично преживяване. Натискаме Enter, отброяваме секундите и думите започват да се редят пред нас. В центровете на OpenAI между тези две събития се движат огромни количества данни. Моделът трябва да бъде наличен в паметта, изчислителните блокове да обработят заявката, информацията да премине между различните части на системата, а при големите модели множество ускорители да работят едновременно и да обменят резултати.
При обикновен въпрос това се случва достатъчно бързо, за да не мислим за него. При AI агент картината е друга. Той може да прочете документ, да направи план, да извика инструмент, да провери резултата и да продължи към следващата стъпка. Една задача се превръща в поредица от inference операции. Колкото по-дълга е работата, толкова пъти повече се плаща за нея – измеримо във време, електричество и изчислителен ресурс.
Тук специализираният хардуер започва да придобива смисъл. Универсалният GPU на NVIDIA трябва да бъде добър в много различни неща. ASIC, от друга страна, може да бъде проектиран с много по-тясна философия в себе си: как да изпълнява определен тип работа възможно най-ефективно. OpenAI познава собствените си модели, знае как те се държат в реални заявки и може да използва това знание още преди първият транзистор на чипа да бъде произведен.
При Jalapeño изчислителните блокове, паметта и комуникацията между компонентите са проектирани като части от една система. Целта е не просто чипът да изчислява бързо, а възможно най-голяма част от електроенергията да се превърне в полезна работа, вместо да бъде изгубена в прехвърляне на данни и изчакване.
Това е една от големите разлики между собствен и купен хардуер. Nvidia трябва да направи ускорител, който да бъде полезен за огромен брой компании, модели и приложения. OpenAI може да си позволи да изгради нещата наобратно – започвайки от работата, която иска да се свърши, и да построи машината около нея.

Jalapeño щади сметката за ток
Jalapeño е проектиран за 700 вата номинална мощност, като в публикуваните тестове продължителната му консумация достига до около 550 вата. За сравнение, използваните в тестовете системи Nvidia GB200 и GB300 имат ускорители с по-висока номинална мощност. Jalapeño също така разполага с шест HBM4 памети с общ капацитет 216 GiB и пропускателна способност 15.4 TB/s.
Един чип не променя сметката заради 700 вата. Хиляди чипове ефективно го правят.
Центърът за данни не оперира с един ускорител, а с огромни масиви от тях. Всеки идва придружен от памет, мрежи, захранване и охлаждане. Разликата в консумацията не остава суха характеристика в техническата спецификация, особено ако я умножиш по хиляди устройства и хиляди часове работа.
Затова OpenAI поставя производителността на единица мощност толкова високо в резултатите си. При тестовете Jalapeño попада на т.нар. Pareto frontier за трите модела – при съответните режими няма друга сравнявана система, която едновременно да предлага повече производителност и по-ниска латентност. При Kimi K2.5 1T OpenAI отчита около 1.5 пъти по-висока производителност на ват и 3.4 пъти по-ниска крайна латентност спрямо референтната система.
Тук обаче има ясна граница при сравненията. Jalapeño не е тестван срещу всяка конфигурация на Nvidia, а срещу конкретни системи при конкретни натоварвания. Следващото поколение на Nvidia вече е Vera Rubin. SemiAnalysis поставя Jalapeño и Rubin много по-близо един до друг при някои показатели, отколкото директното сравнение с Blackwell би подсказало, включително при разхода за обработване на токени.
Jalapeño не е чипът, който изведнъж прави Nvidia остаряла. Той е първото доказателство, че OpenAI може да изгради собствена алтернатива за определена част от работата.
Собственият силиций дава свобода
OpenAI далеч не се опитва да изхвърли Nvidia от центровете си за данни. Компанията ще продължи да използва ускорители на Nvidia и други производители както за обучение, така и за inference. Jalapeño добавя още един инструмент към арсенала, и засега няма амбиции да замени всички останали.
Това вече се случва и при други големи технологични компании. Google има TPU, Amazon разработва Trainium и Inferentia, Microsoft прави собствен силиций, а Meta развива MTIA. Причината е икономическа: когато една компания използва достатъчно изчислителна мощ, разходът за нея престава да бъде просто цена на закупения ускорител. В сметката влизат електричество, охлаждане, памет, мрежи, сървъри, поддръжка и всичко останало, което превръща един чип в работещ център за данни.
Универсалният ускорител има огромно предимство – може да бъде използван за много различни задачи. Но това предимство има и цена. Ако една компания знае какви модели ще изпълнява и как ще ги използва години наред, тя може да си позволи да изреже част от универсалността и да замени спестеното с по-висока ефективност.
Точно тук историята става интересна за Nvidia.
Не защото Jalapeño ще я измести. Един собствен чип на OpenAI не е достатъчен за това. По-същественото е, че най-големите купувачи на AI изчислителна мощ придобиха мащаб, който прави собствения дизайн възможен.
Ако това се превърне в устойчива тенденция, Nvidia няма непременно да загуби пазара. Може да загуби част от неговата универсалност.

Девет месеца до tape-out
Jalapeño е разработен съвместно с Broadcom, а Celestica участва в системната интеграция. OpenAI посочва деветмесечен период от началния дизайн до tape-out – момента, в който проектът е готов да бъде предаден за производство. Работата по целия проект е започнала много по-рано: според SemiAnalysis началото е положено в средата на 2024 г., а от сформирането на екипа до производствения tape-out са минали приблизително 16 месеца.
Това темпо има значение заради онова, което стои зад първото поколение. OpenAI вече работи по Gen 2, а след него и по Gen 3. През 2025 г. компанията и Broadcom обявиха план за 10 GW персонализирани AI ускорители. Jalapeño не е замислен като единичен проект, който трябва да докаже, че OpenAI може да направи чип. Той е началото на цяла хардуерна линия.
И това дава на компанията нещо, което не може да се купи от каталог: възможността следващият чип да бъде правен върху информацията, натрупана от предишния. Как се държат реалните модели. Къде се бавят. Кои операции струват най-много. Какво се случва, когато един агент изпълнява дълга задача вместо кратка заявка.
Следващата версия няма да започне от нулата.
Когато AI помага да бъде създаден AI хардуер
Един необичаен информационен слой бие на очи в историята. OpenAI използва собствените си модели при разработването на Jalapeño. По-ранни модели са участвали в проектирането и първоначалното въвеждане на чипа, а по-новите се използват за програмиране и оптимизация. При някои от най-важните изчислителни операции в моделите OpenAI е използвала собствените си AI инструменти, за да помагат при писането и оптимизирането на програмния код. Според компанията кодът, създаден с помощта на Codex и GPT-Astra за отделни компоненти на моделите, работи между 1.5 и 1.8 пъти по-бързо от предишните версии, написани от инженери. Това не означава, че самите AI модели са станали до 1.8 пъти по-бързи – сравнението се отнася само до конкретните части от кода, върху които е работено.
Инженерите не са изчезнали от процеса. Те определят архитектурата, проверяват резултатите и решават кои решения могат да стигнат до производство. Променя се времето, необходимо за отделните итерации: AI може да предложи код, да потърси по-ефективен вариант, да анализира резултатите от тестовете и да подготви следващото решение, докато човекът продължава да задава посоката.
Така AI взима дейно участие в създаването на машините, върху които самият той ще работи. Моделите изискват все повече изчислителна мощ, а същите тези системи вече могат да помагат при проектирането и оптимизирането на хардуера, който ще я осигури. OpenAI вижда как собствените ѝ модели използват машините днес, използва тази информация при разработването на следващия чип и след това отново прилага AI, за да извлече допълнителна производителност от него.
Това е цикъл, който с всяко поколение може да се затваря все по-плътно.

Евтиният inference променя какво можем да искаме от AI
В разговорите за AI обикновено се говори за интелигентността на модела. По-рядко за цената на едно негово действие.
Но цената определя поведението.
Ако една заявка е скъпа, агентът ще прави по-малко проверки. Ако всяка следваща стъпка струва много изчислителна мощ, задачите ще бъдат ограничавани до това, което има икономически смисъл. Когато inference стане по-евтин, границата се измества. Агентът може да прочете още един документ, да направи още една проверка, да опита още един подход или просто да остане активен по-дълго.
Това е причината специализираният хардуер да има значение далеч отвъд центъра за данни. По-ефективният чип може да не се вижда на екрана, но може да повиши обема работа, която една AI система ще извърши зад този екран.
Ако това се случи в достатъчно голям мащаб, AI няма просто да бъде по-бърз. Ще стане икономически възможно да бъде използван за повече неща.
Пазарът не чака „убиец на Nvidia“
Jalapeño се появи точно преди Nvidia да публикува поредния си финансов отчет, но пазарът не реагира с разпродажба на акциите на компанията заради новия чип. Вниманието на инвеститорите бе насочено към резултатите на Nvidia, перспективите пред Blackwell и Vera Rubin и способността на компанията да запази темпа на растеж на AI бизнеса си. Custom silicon беше сред факторите, които анализаторите следят, но не като внезапна заплаха, която да промени оценката на Nvidia за една нощ.
Това е разбираемо. Jalapeño тепърва трябва да бъде внедрен в реалната инфраструктура на OpenAI. Компанията планира първоначално използване в малък обем до края на 2026 г., а по-широкото разгръщане е насочено към 2027 г.
За инвеститорите по-интересният въпрос е как ще изглежда AI инфраструктурата след няколко години, ако всяка от най-големите компании има собствено решение за част от натоварването си.
Nvidia има сериозни защити. CUDA и цялата софтуерна екосистема около нея са трудни за заместване. Компанията има огромен опит при обучението на модели, мрежите, системната интеграция и универсалните AI натоварвания. Собственият ASIC на една компания не може да възпроизведе всичко това бързо.
Но и обратното е вярно: ако специализираните ускорители постепенно поемат голяма част от inference, универсалността на Nvidia ще стане нещо, за което клиентите не винаги биха искали да плащат.

Истинският тест е в центъра за данни
OpenAI планира първото внедряване на Jalapeño до края на 2026 г. След това започва по-трудната част. Чипът трябва да бъде произведен в достатъчни количества, да заработи надеждно, да бъде интегриран с паметта и мрежите, да се охлажда ефективно и да издържа на реални натоварвания 24/7.
Тогава ще разберем колко от резултата в InferenceX може да бъде пренесен в истински център за данни.
Един benchmark измерва архитектурата. Хиляди ускорители измерват бизнеса.
Там ще се реши и по-големият въпрос за Nvidia. Не дали OpenAI може да направи един чип добър, а дали най-големите потребители на AI ще продължат да купуват универсален хардуер за всяка задача или постепенно ще започнат да изграждат собствени машини за най-важната част от бизнеса си.
Google вече има TPU. Amazon има Trainium и Inferentia. Microsoft и Meta развиват свои ускорители. OpenAI вече има Jalapeño.
На този фон Nvidia все още е гигантът в центъра на пазара. Но вече не е единственият, който решава как трябва да изглежда една AI машина.
Хардуерът като част от AI
Допреди няколко години AI индустрията говореше основно за модели, параметри и данни. После центровете за данни и GPU-тата станаха част от разговора. Сега границата се измества за пореден път.
Моделът определя каква работа трябва да бъде свършена. Софтуерът определя как да бъде изпълнена. Чипът определя колко бързо и ефективно може да стане това. Паметта, мрежата, охлаждането и електричеството определят дали всичко останало може да работи заедно.
OpenAI вече гледа на тези части като на една система. По-добрият хардуер прави inference по-евтин. По-евтиният inference позволява повече AI действия. Реалните действия показват къде хардуерът трябва да бъде подобрен. Следващият чип ще бъде проектиран на базата на тази информация.
Jalapeño е първият публичен резултат от този цикъл.
Няма да го видим в лаптопа си. Няма да го купим от магазин. И вероятно никога няма да разберем дали точно този чип е генерирал конкретния отговор, който сме получили от ChatGPT.
Но ако OpenAI успее да пренесе резултатите от лабораторията в центровете за данни, ефектът ще стигне до нас по един много по-обикновен начин: повече AI работа за същото количество енергия, по-малко чакане и задачи, които преди са били прекалено скъпи, за да бъдат оставени на машина.
В тази история Jalapeño не е „убиецът на Nvidia“. Не е и просто поредният AI чип.
Той е знак, че най-големите потребители на изкуствен интелект вече са достатъчно силни, за да започнат да проектират собствените си машини.
И ако това се окаже трайна промяна, следващият етап от AI надпреварата няма да се решава само от това кой има най-добрия модел.
Ще се предопредели и от това кой е построил най-подходящата машина, за да го накара да работи по-ефективно.