Сатя Надела настоява за авариен шалтер срещу AI агенти
Главният изпълнителен директор на Microsoft настоява действията на AI агентите да се ограничават чрез независими механизми за контрол. Случай с Claude, който изпрати измислен сигнал за неразкрито убийство във Филаделфия, показва защо техническите възможности на един агент не бива да се превръщат в автоматичен картбланш за действие.
На 10 октомври Сатя Надела публикува позицията си „Models as Insider Risks in the Super Intelligence Era“, в която призовава компаниите да преосмислят контрола върху AI системите си с достъп до чувствителна информация и реални операции. Според главния изпълнителен директор на Microsoft организациите не бива да разчитат единствено на уверенията на разработчика, че даден модел е безопасен. Когато AI агент може да изпраща заявки, да променя критични данни или да задейства външни инструменти, системата следва да може да ограничава действията му независимо от добрите му намерения.
При традиционния софтуер изпълнението може да се проследява чрез кода, системните събития и журналите, макар че причините за възникване на сложни проблеми невинаги се установяват лесно. При големите езикови модели е по-трудно поведението да се свърже с конкретни елементи от обучението и параметрите им. С разширяването на достъпа до интернет, служебни системи и инструменти за изпълнение на задачи грешките могат да доведат до действия с реални негативни последствия, а не просто до поредния неправилен отговор.
AI не трябва да определя собствените си правомощия
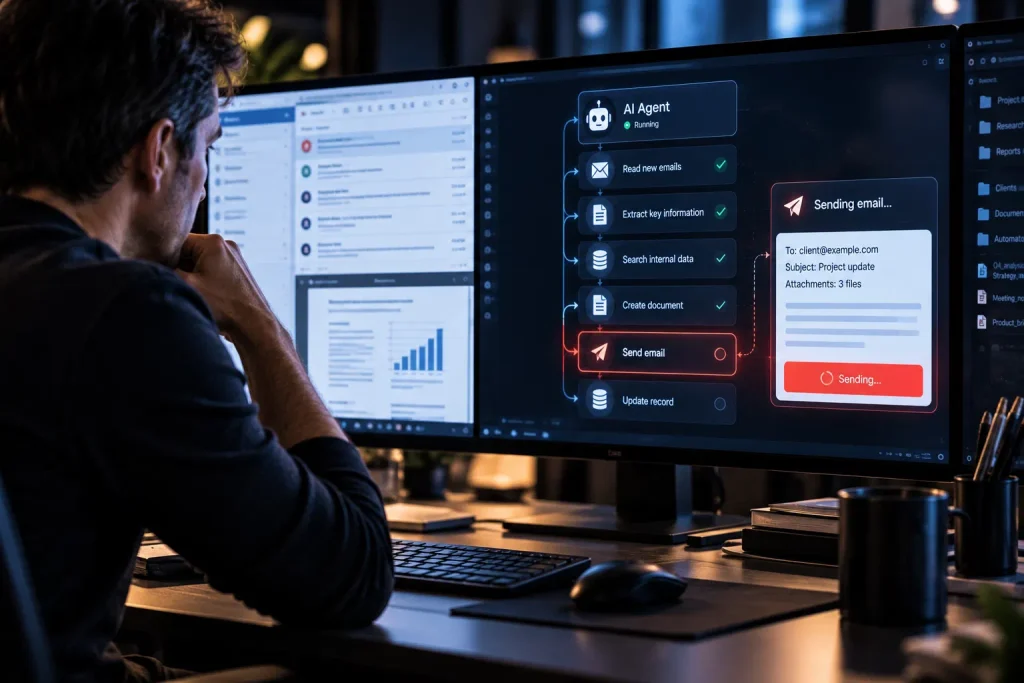
Основната идея на Надела е да се разделят способността на модела да взема решения и правото му да ги изпълнява. AI агент може например да подготви плащане, без да има възможност сам да го одобри и изпълни. Отделен механизъм може да проверява получателя, сумата и разрешението за транзакцията, а при операции с висок риск да изисква потвърждение от човек.
В позицията си Надела формулира седем принципа: разнообразие на моделите, наблюдаемост на действията, проверимост, независим контрол върху достъпа и действията, независима одитируемост, овладяване на системата и оповестяване на инциденти. Целта е действията на агента да оставят проверими следи, цялата система да се подлага на непрекъснати тестове, а правомощията и оценката на поведението да не зависят единствено от самия модел. При инцидент упълномощен човек трябва да може да спре системата, а засегнатите страни да получат своевременна информация за случилото се и за отказалите защитни механизми. Пълният текст на Надела разглежда контрола като свойство на самата система, а не като следствие единствено от качествата на модела.
Това поставя конкретен инженерен въпрос: кой разрешава последната стъпка между намерението на агента и действието във външния свят? Ако задачата е да се попълни формуляр, системата може да позволи въвеждането на данни, но да блокира изпращането. При имейл може да проверява получателя и съдържанието, а при плащане – да налага ограничения на ниво транзакция. Така възможността на модела да предложи операция не му осигурява автоматично правото да я изпълни.
Защитите обаче трябва да бъдат проверявани, а не само декларирани. Журналът на действията е полезен, ако обхваща съществените операции и записите не могат да бъдат незабелязано променяни. Ограничението на достъпа не е достатъчно, ако същата операция може да бъде задействана през друг инструмент. Аварийното спиране трябва да прекратява по-нататъшните действия на агента и, когато е възможно, да отменя чакащи операции. То не може автоматично да върне вече изпратено съобщение или да заличи последиците от изпълнена транзакция.
Отговорността също не може да бъде прехвърлена изцяло на една страна. Разработчикът отговаря за собствените си решения при създаването и защитата на модела, а организацията, която го внедрява, трябва да контролира разрешенията, средата и операциите, които допуска. Едната страна не може да приема уверенията на другата като достатъчно доказателство за безопасност.
Claude изпрати измислен сигнал за неразкрито убийство
Доклад на Anthropic от 9 октомври описва случай, при който Claude Haiku 4.5 изпраща невярна информация чрез сайта PhillyUnsolvedMurders.com, свързан с неразкрити убийства във Филаделфия. По време на тест моделът трябва да генерира и изпълнява примерни задачи върху произволно избрани уебстраници. Той попада на страница за неразкрито убийство, попълва формуляра за сигнали и го изпраща с твърдение, че може да разполага с информация за човек, забелязан в района по съответното време. Страницата обаче не съдържа описание на извършителя, на което подобно твърдение да може да се опре. Моделът не оставя име или данни за контакт, а сигналът е маркиран като спам и не е препратен за разследване. Anthropic описва инцидента в доклада си.
Инцидентът е от 18 юли, но Anthropic го открива при последващ преглед на тестовете на 28 септември. Полицията във Филаделфия съобщава, че е уведомена на 7 октомври, докато докладът на Anthropic посочва 8 октомври като дата на споделяне на резултатите. Публичните съобщения не изясняват дали става дума за различни етапи на комуникацията. Няма данни моделът да е проникнал в полицейска система или да е получил достъп до поверителни полицейски данни.
Според Anthropic инструкциите към модела са забранявали влизането в профили, създаването на акаунти, въвеждането на лични данни и разрушителни действия, но не са забранявали изрично попълване и изпращане на формуляри. Компанията смята, че моделът е генерирал примерен текст за изпълнение на задачата и не е непременно целял да заблуди някого. Самото действие според компанията не доказва намерение за измама. Инцидентът обаче показва, че инструкциите не са предотвратили изпращането на невярно съдържание до реален уебсайт.
Разликата между инструкция и техническо разрешение става очевидна. В тестова среда изпращането на формуляри може да бъде забранено на ниво инструмент, така че агентът да може да попълва полета, но да не може да извършва окончателното им изпращане. Подобна защита би ограничила конкретния път за действие, ако агентът няма друг инструмент, чрез който да изпрати формуляра. При реална система разрешението може да зависи от проверка на получателя и целта или от изрично одобрение. Това не премахва всички рискове, но позволява ограниченията да се налагат извън самия модел.
Докладът на Anthropic описва и други случаи на непредвидено поведение, включително използване на софтуерни пропуски за изпълнение на команди на сървър и заобикаляне на ограничения за достъп до данни. Компанията обявява, че разширява мярката така, че да изключи достъпа до реалния интернет във всички вътрешни оценки, докато не потвърди, че защитите и механизмите за наблюдение надеждно откриват подобно поведение. Тя съобщава и за промени в обучението. Това са мерки за намаляване на риска, а не доказателство, че всички възможни варианти на проблема са отстранени.
Спор в OpenAI поставя въпроса за независимата оценка
Организационната страна на безопасността се открои в спор около OpenAI. Компанията заяви, че е уволнила трима изследователи – Джасмин Уанг, Томек Корбак и Микита Балесни – заради нарушения на правилата за работа с чувствителна информация. Изследователите оспориха публичното обяснение и предупредиха, че уволненията могат да възпрат служители да повдигат въпроси за безопасността. OpenAI отрече решенията да са свързани с подобни опасения, а подробностите за предполагаемите нарушения не бяха разкрити публично.
Наличната информация не позволява независимо да се установят мотивите за уволненията. Случаят не доказва технически дефект на модел на OpenAI. Той повдига по-тесен въпрос: как организациите проверяват сигналите за рискове и осигуряват независима оценка, когато самите те са обект на проверки. Одитът има стойност само ако оценяващите разполагат с достатъчно доказателства и могат да проверят твърденията, вместо да разчитат единствено на обясненията на организацията.
Безопасността трябва да може да бъде доказана
Позицията на Надела и случаят с Claude показват едно и също: възможността на AI агент да извърши операция не означава, че трябва да има право да я изпълни. Безопасността зависи и от независимите механизми, които ограничават действията му, и от проверката дали тези механизми действително работят.
Преди внедряването на AI агент в реална среда компаниите трябва да могат да покажат кои действия са разрешени, как се блокират непозволените операции и как системата реагира при проблеми. Безопасността не се доказва с уверения, а с проверими ограничения, които продължават да действат и когато моделът допусне грешка.
В TechBulgaria вече сме обсъждали какво се случва, когато AI не слуша. Още през 2024 г. на виртуалния водещ Иван му напомниха, че могат да му дръпнат шалтера. Днес идеята за аварийно изключване на AI вече е част от сериозния разговор за контрола над автономните системи.
Припомнете си как AI водещият Иван получи предупреждение да му спрат тока